


 فيسبوك
 واتساب

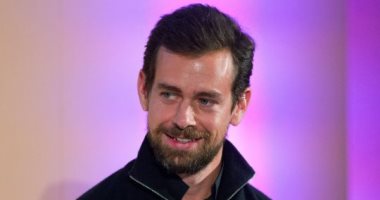
كشفت شركة «بلوك» (Block)، التي أسسها جاك دورسي، المؤسس المشارك لتويتر، عن نموذج ذكاء اصطناعي جديد يحمل اسم «Dessa»، يستهدف جعل المحادثات مع الذكاء الاصطناعي أكثر طبيعية وشبهًا بالتواصل البشري، مع إمكانية تشغيله محليًا على أجهزة ماك بوك المتطورة دون الحاجة إلى الاتصال بالإنترنت، ويختلف النموذج الجديد عن كثير من أنظمة الذكاء الاصطناعي الصوتية، إذ يعتمد على التدريب باستخدام المحادثات الصوتية البشرية مباشرة، بدلًا من الاعتماد على نماذج لغوية ضخمة أو تحويل الكلام إلى نص قبل معالجته.
We made the first AI model you can have a realistic conversation with that was trained entirely on speech! Dessa is a full-duplex speech-to-speech model that you can run on consumer GPUs. This is a GPT3 moment for speech. https://t.co/XVD8sSyJn8
— Ragavan Thurairatnam (@RagavanThurair) October 23, 2026
كيف يتحدث Dessa مثل البشر؟
تعتمد معظم أنظمة المساعدات الصوتية التقليدية على تحويل كلام المستخدم إلى نص، ثم معالجة النص وإنتاج رد صوتي، وهي عملية قد تفقد بعض التفاصيل الموجودة في الصوت الأصلي، مثل المشاعر والسخرية والضحك وطريقة التوقف أثناء الحديث، أما «Dessa»، فيعتمد على تقنية المحادثة الصوتية المباشرة، التي تتيح له الاستماع والتحدث في الوقت نفسه، وهي تقنية تُعرف باسم «Full-Duplex Speech-to-Speech».
وبحسب الفريق المطور، يستطيع النموذج التفاعل بصورة أكثر سلاسة، من خلال المقاطعة الطبيعية أثناء الحديث، وإبداء ردود فعل سريعة مثل الموافقة أو إظهار الفهم، بل والضحك في أثناء الجملة عندما يكون السياق مضحكًا، كما يستهدف التعرف على المشاعر والتغيرات في نبرة الصوت والسخرية، وهي إشارات قد يصعب الاحتفاظ بها عند تحويل المحادثة إلى نص مكتوب.
يعمل دون إنترنت على أجهزة ماك بوك
من أبرز مزايا «Dessa» إمكانية تشغيله محليًا على جهاز «MacBook Pro» المزود بمعالج «M4 Max» أو جهاز أعلى قدرة، دون الحاجة إلى اتصال بالإنترنت، وفقًا للتقرير، ويعني التشغيل المحلي أن معالجة المحادثة يمكن أن تتم على الجهاز نفسه بدلًا من الاعتماد على خوادم سحابية لتشغيل النموذج، وهو ما قد يفتح المجال أمام استخدامات صوتية أكثر استقلالًا عن الاتصال بالشبكة، وكشف الفريق أن تدريب النموذج تم باستخدام نظام حوسبة واحد من «إنفيديا» يحمل اسم «GB200 NVL72»، في إطار أبحاث تستكشف إمكانية تعلم اللغة والتواصل اعتمادًا على الصوت وحده.
جاك دورسي: لا يعتمد على نماذج لغوية ضخمة
رد جاك دورسي على أسئلة المستخدمين عبر منصة «إكس» بشأن التقنية التي تقف وراء النموذج، موضحًا أنه يعتمد على أسلوب «الصوت إلى الصوت» دون استخدام نموذج لغوي ضخم (LLM)، وعندما سُئل عما إذا كان بالإمكان تشغيله محليًا، أجاب بالإيجاب، في إشارة إلى إمكانية استخدامه دون الاعتماد على خدمات الذكاء الاصطناعي السحابية، وتدعو الشركة حاليًا مجموعة محدودة من الباحثين المتخصصين في سلامة الذكاء الاصطناعي إلى تجربة النموذج، بهدف اكتشاف المخاطر المحتملة التي ربما لم ينتبه إليها المطورون.
هل ينافس ChatGPT وGemini؟
يمثل «Dessa» توجهًا مختلفًا عن الأنظمة الصوتية المرتبطة بمساعدات مثل «ChatGPT» و«Gemini»، إذ يركز على تعلم المحادثة من الصوت مباشرة بدلًا من الاعتماد على نموذج لغوي ضخم لمعالجة النصوص ثم توليد الردود، لكن المشروع لا يزال في مرحلة البحث والتطوير المبكر، ولا تعني قدرته على إجراء محادثات صوتية طبيعية أنه يقدم بالضرورة المستوى نفسه من المعرفة أو الاستدلال الذي توفره النماذج اللغوية العامة، وإذا أثبتت هذه التقنية نجاحها، فقد تفتح الباب أمام جيل جديد من المساعدات الصوتية القادرة على فهم تفاصيل الحديث البشري بصورة أفضل، مع العمل محليًا على الأجهزة الشخصية ودون اتصال دائم بالإنترنت.


