


 فيسبوك
 واتساب

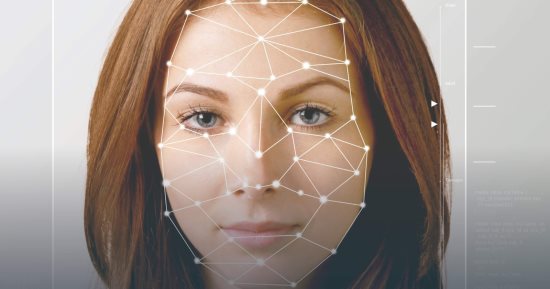
كشفت دراسة أولية أن نماذج الذكاء الاصطناعى ChatGPT وClaude وGrok وGemini، تستطيع محاكاة ترتيب البشر لجاذبية الوجوه بدرجة عالية، لكنها تمنح الوجوه درجات أعلى بشكل واضح عند تقييم الجاذبية على مقياس مطلق، ما يشير إلى قدرتها على إدراك الجمال النسبى مع ميل منهجى للمبالغة فى تقديره مقارنة بالبشر.
وقاد البحث سانتياغو غرانداس، رئيس قسم الأبحاث النفسية فى شركة QOVE، التى تضم مختبرا متخصصا فى دراسة تصورات الجاذبية الجسدية، بهدف معرفة ما إذا كانت نماذج الذكاء الاصطناعى الحديثة تقيم الوجوه بالطريقة نفسها التى يقيمها البشر، خاصة مع استخدام هذه الأدوات بشكل متزايد لتقييم المظهر.
واستخدم الباحثون 102 صورة أمامية لأشخاص من مجموعة مختبر أبحاث الوجه فى لندن، مقسمة بشكل متقارب بين الذكور والإناث ومن خلفيات عرقية متنوعة، وحصلوا على تقييمات من 2513 مشاركا على مقياس من 1 إلى 7، ثم طلبوا من النماذج الأربعة تقييم الصور نفسها بالإعدادات الافتراضية، وفقا لموقع مجلة psypost.

معايير الجمال تختلف على برامج الذكاء الاصطناعي
النماذج تتفق مع ترتيب البشر
أظهرت النتائج أن النماذج استطاعت محاكاة الترتيب النسبى للوجوه بدقة كبيرة، فإذا اعتبر البشر وجها أكثر جاذبية من آخر، اتفقت النماذج معه فى هذا الترتيب فى معظم الحالات، بل تمكنت من محاكاة متوسط ترتيب الوجوه لدى البشر بدقة أكبر من أى مقيم بشرى عادى.
لكن التوافق اختفى تقريبا عند مقارنة الدرجات المطلقة، إذ بلغ متوسط تقييم البشر لجميع الوجوه 3.02، مقابل 4.71 فى تقييمات الذكاء الاصطناعى، كما استخدمت النماذج نطاقا أضيق من مقياس 1 إلى 7، ولم تمنح أى وجه أدنى درجة ممكنة، بينما كان جروك النموذج الوحيد الذى منح أعلى تقييم لأى وجه، وبلغ متوسط درجاته 5.21.
وأظهرت المقارنة بين النماذج توافقا قويا بين شات جى بى تى وكلاود وجيميناي، بينما كان جروك حالة مختلفة بوضوح، إذ حقق أعلى متوسط للتقييمات وأضعف توافق مع النماذج الأخرى ومع تقييمات البشر، وقال غرانداس أن هذا الاختلاف يوضح أن النماذج لا تقيم الوجوه بالطريقة نفسها التى يفعلها البشر رغم قدرتها على محاكاة ترتيبهم النسبى.
تحيزات مختلفة وأسئلة مفتوحة
وجدت الدراسة أن الوجوه الأكبر سنا حصلت باستمرار على تقييمات أقل من البشر والذكاء الاصطناعى، بينما كانت بعض تحيزات البشر الأخرى أقل وضوحا لدى النماذج، إذ منح البشر وجوه الذكور درجات أقل بنحو 0.65 نقطة من وجوه الإناث، مقابل فارق تراوح بين 0.1 و0.2 نقطة لدى الذكاء الاصطناعى، كما قدمت النماذج تقييما أكثر تقاربا بين الخلفيات العرقية مقارنة بالعينة البشرية.
وأشار ماكين مورفى، كبير العلماء فى QOVES والمشارك فى تأليف الدراسة، إلى أن هذا المجال جديد ويصعب فهمه، موضحا أن النماذج قد تدرك الجاذبية بشكل مشابه للبشر، لكنها تقدم أرقاما أكثر إيجابية ضمن ظاهرة أوسع تعرف باسم "التملق الآلي"، محذرا من احتمال ترسيخ الامتياز إذا استخدمت الشركات هذه الأدوات لإزالة التحيز البشرى من عمليات مثل تقييم المرشحين.
وشملت الدراسة اختلافات محدودة بين مجموعات المقيمين، إذ كانت تقييمات النماذج أقرب قليلا إلى تفضيلات النساء مقارنة بالرجال، كما أظهرت النماذج باستثناء جروك توافقا أقوى قليلا مع الأشخاص الذين أفادوا بانجذابهم إلى الجنسين مقارنة بمن ينجذبون إلى الرجال فقط، وتتوافق هذه النتائج مع بحث سابق أظهر توافقا كبيرا بين تقييمات شات جى بى تى للسمات الاجتماعية للوجه والانطباعات البشرية.
وتوجد عدة محاذير للنتائج، فالدراسة ما زالت نسخة أولية لم تخضع لمراجعة الأقران، كما أن تقييمات البشر اعتمدت على ردود فردية بينما تم حساب متوسط درجات الذكاء الاصطناعى عبر عدة تجارب، ما يجعل درجات النماذج أكثر استقرارا بحكم التصميم، إضافة إلى أن معظم المقيمين كانوا من الشابات اللاتى ينجذبن إلى الرجال، وأن صور الوجوه كانت منحازة بشكل كبير نحو الأشخاص البيض.
كما لم تتوفر الخلفيات العرقية للمقيمين البشريين، ولم تعد الصياغة الدقيقة للاستبيان الأصلى متاحة، ما قد يعنى اختلاف التعليمات المقدمة للذكاء الاصطناعى عن تلك التى تلقاها المشاركون، وقال غرانداس أن النماذج لا ينبغى اعتبارها حكما محايدا على المظهر، مؤكدا أنها تميل إلى اعتبار الوجوه أعلى من المتوسط بغض النظر عن مظهرها الحقيقى.
ويريد فريق البحث مستقبلا تحديد العوامل التى تقف وراء اتفاق البشر واختلافهم فى أحكام الجمال، من خلال دراسة نطاق أوسع وأكثر تنوعا من المشاهدين والوجوه، كما أتاح الفريق صفحة تتضمن ملخصا للنتائج والبيانات وبعض الرسوم البيانية التفاعلية، بينما حملت الدراسة عنوان "الجمال يكمن فى الذكاء الاصطناعى للناظر: نماذج التعلم الآلى متعددة المستويات تبالغ بشكل منهجى فى تقدير جاذبية الوجه"، من تأليف سانتياغو غرانداس، وخوان سيباستيان سيلى أكوستا، وموهيت منديراتا، وشافى حسن، وماكين مورفى.